

 这种能力使其在长程、复杂任务中表现出色,并在 SWE、BrowseComp、xBench 等 Code & Agent Benchmark 上达到了 SOTA 水平。
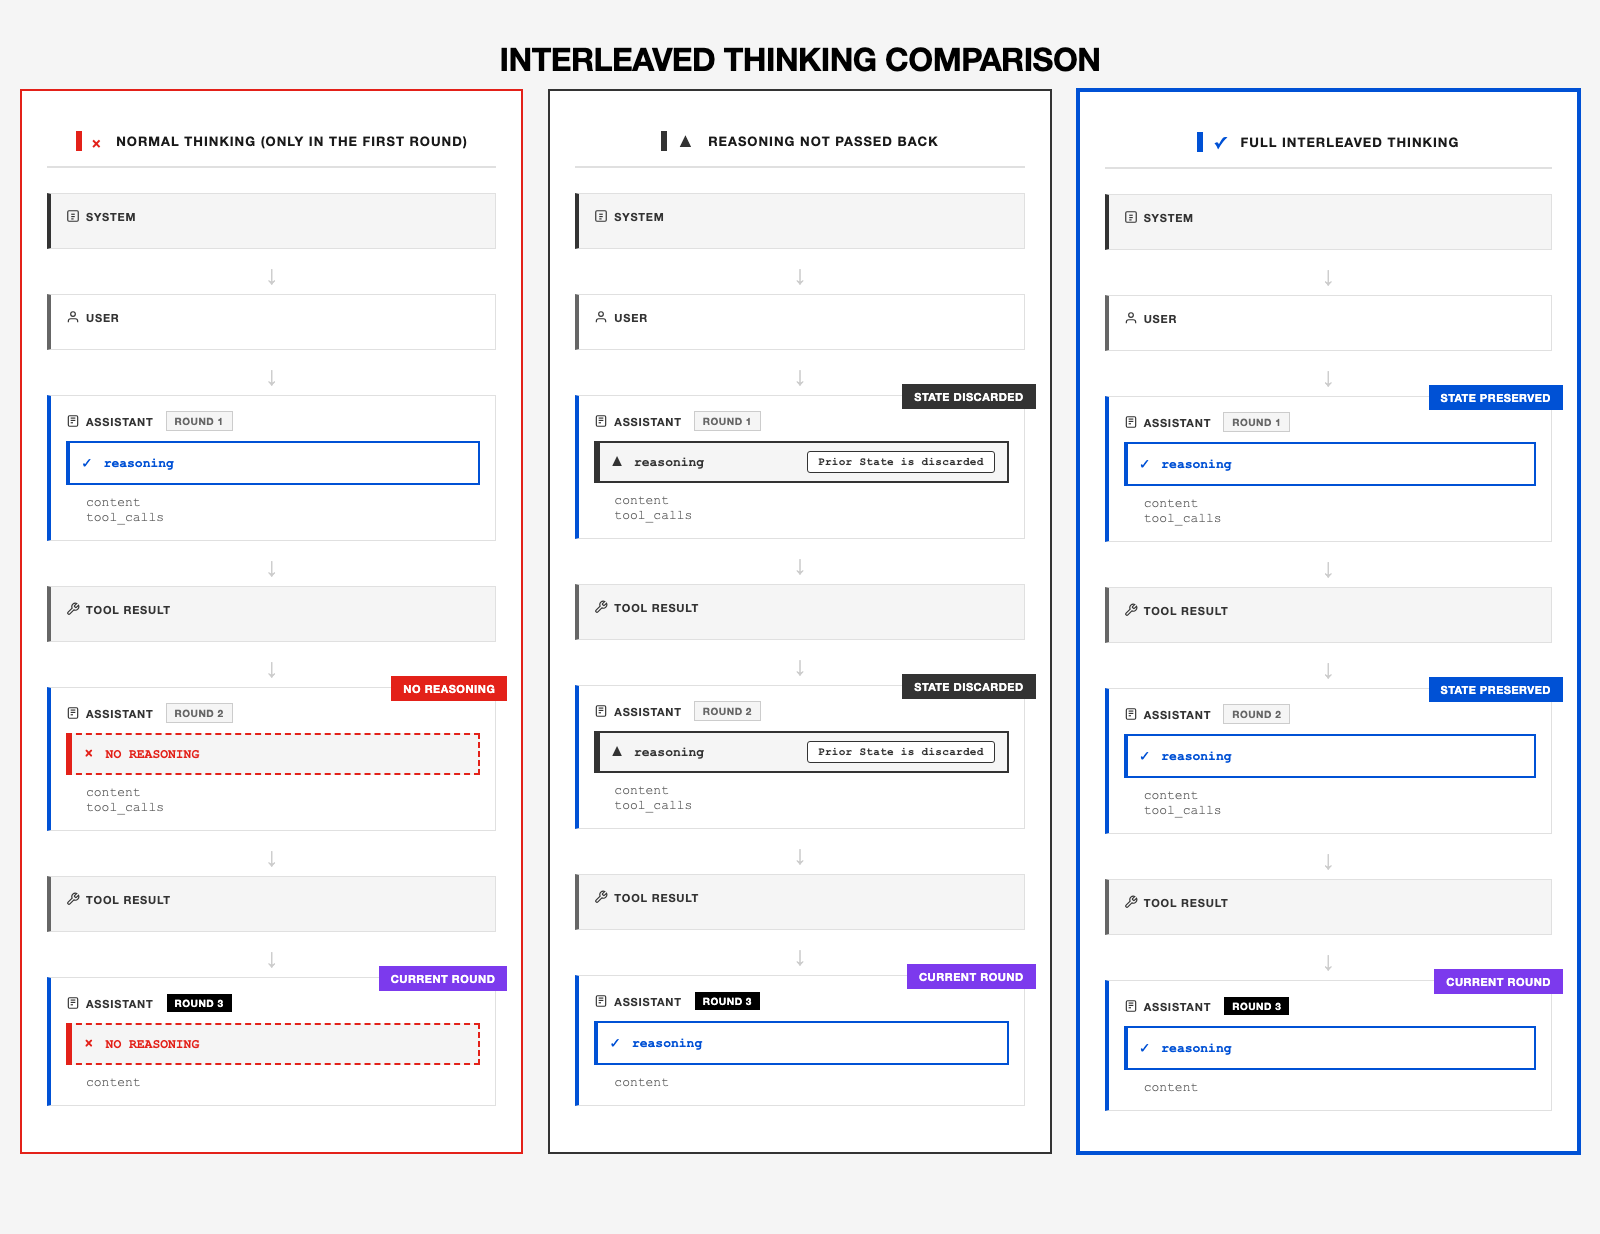
下面我们通过具体的案例,说明 MiniMax-M3.1-Flash 在 Tool Use 和 Interleaved Thinking 上的最佳实践,它的核心是:回传每一次模型 Response 的全部信息,尤其是其中的思考字段(
thinking / reasoning_content)。
参数说明
请求参数说明
tools: 定义可调用的函数列表,包含函数名、描述和参数规范
响应参数说明
工具使用响应中的关键字段:thinking/reasoning_content: 模型的思考(thinking)text/content: 模型输出的文本tool_use/tool_calls: 模型决定调用工具name/function.name: 被调用的工具名称input/function.arguments: 工具调用参数(OpenAI 格式下为 JSON 字符串)id: 工具调用的唯一标识符
MiniMax-M3.1-Flash 按需思考:在简单的工具调用中,模型可能直接调用工具而不输出思考内容,此时该轮响应中没有
thinking 内容块或 reasoning_content 字段。解析时请先判断字段是否存在,无论本轮是否包含思考内容,都需要完整回传模型返回的消息。特别注意
在多轮 Function Call 对话中,必须将完整的模型返回(即 assistant 消息)添加到对话历史,以保持思维链的连续性: OpenAI SDK:- 将完整的
response_message对象(包含reasoning_content和tool_calls字段)添加到消息历史 - 模型的思考内容通过
reasoning_content字段返回,回传时需要一并保留
- 将完整的
response.content(包含 thinking/text/tool_use 等所有块)添加到消息历史 response.content是一个列表,包含多种类型的内容块,必须完整回传
请求示例
Anthropic SDK
配置环境变量
示例代码
OpenAI SDK
配置环境变量
示例代码
通过 OpenAI SDK 调用 MiniMax-M3.1-Flash 时,思考内容通过reasoning_content 字段返回,可以直接用于展示。
重要提醒:为了保证 Interleaved Thinking 的生效、模型思维链不被打断,包含
reasoning_content 在内的完整 response_message 必须被保留在 Message History 中,在下一轮调用中回传给模型。如此才能发挥模型的最佳性能!send_messages 的实现,和追加历史消息 messages.append(response_message) 操作:
注意事项
如果在使用MiniMax模型过程中遇到任何问题:- 通过邮箱 Model@minimax.io 等官方渠道联系我们的技术支持团队
- 在我们的 Github 仓库提交Issue
推荐阅读
在 AI 编程工具里使用 MiniMax-M3.1-Flash
具备代码理解能力,适用于代码助手等场景。
文本生成指南
支持通过 Anthropic 和 OpenAI 兼容接口进行文本生成调用
Anthropic API 兼容(推荐)
通过 Anthropic SDK 调用 MiniMax 模型
OpenAI API 兼容
通过 OpenAI SDK 调用 MiniMax 模型